Що таке анотування даних для ШІ? Посібник із маркування навчальних даних
Що таке анотування даних для ШІ
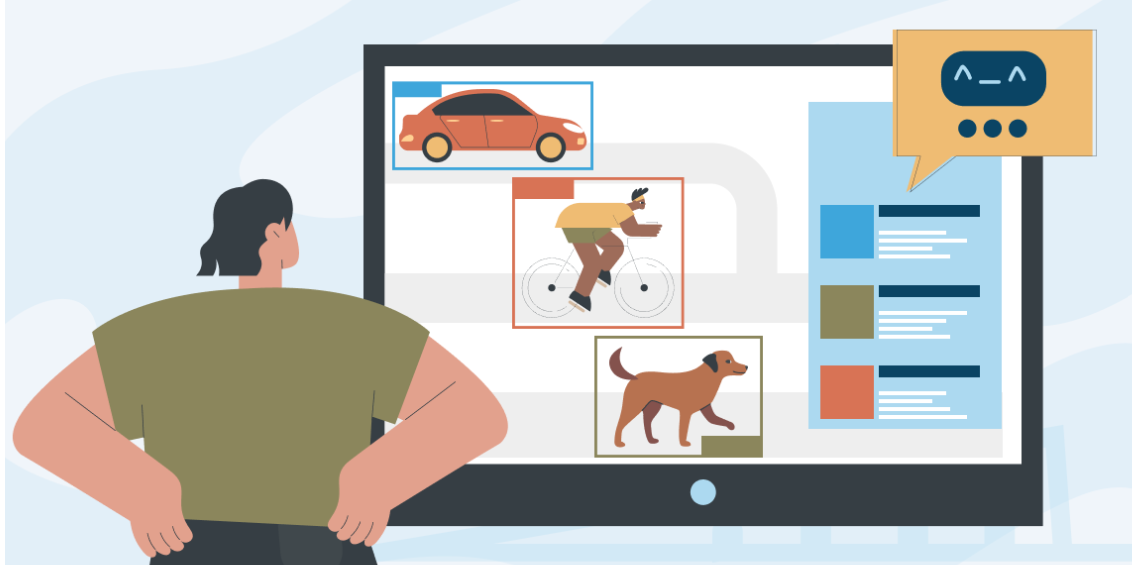
Анотування даних для ШІ (AI data annotation) — це процес маркування та організації первинних даних, завдяки якому системи штучного інтелекту (ШІ) можуть розпізнавати шаблони, інтерпретувати інформацію та робити точні прогнози. Цей процес передбачає додавання змістовних тегів, категорій або контекстних деталей до наборів даних, що використовуються для навчання моделей машинного навчання. Наприклад, анотатори можуть розмічати зображення котів і собак, ідентифікувати імена й локації у тексті, транскрибувати усне мовлення з аудіозаписів або позначати об’єкти та дії у відеоматеріалах. Ці розмічені приклади допомагають алгоритмам зрозуміти, що саме означають різні елементи даних і як обробляти подібну інформацію у майбутньому.
Анотування даних є фундаментальним етапом у розробці надійних моделей машинного навчання, особливо тих, що навчаються «з учителем» (supervised learning). Якість розмічених навчальних даних безпосередньо впливає на те, наскільки ефективно модель навчається, узагальнює нові вхідні дані та працює у реальних умовах. Залежно від проєкту, процес анотування може залучати фахівців-людей, автоматизовані інструменти або їхнє поєднання для підвищення ефективності та збереження точності.
Чому ШІ потребує розмічених навчальних даних
Розмічені навчальні дані надають системам ШІ чіткі приклади того, що саме їм потрібно розпізнавати, класифікувати чи прогнозувати. Під час навчання з учителем алгоритми аналізують вхідні дані разом із відповідними мітками, щоб виявити закономірності та зв'язки, які можна застосувати до нової, ще невідомої інформації. Наприклад, модель ШІ, навчена на електронних листах із мітками «спам» або «не спам», вчиться відрізняти небажані повідомлення від справжнього листування. Саме тому маркування даних є критично важливим для ефективного навчання моделей: без точних міток алгоритм може вивчити хибні шаблони й видавати ненадійні результати. Хоча деякі підходи машинного навчання можуть працювати з нерозміченими даними, розмічені приклади залишаються основою для багатьох практичних застосувань ШІ, зокрема, розпізнавання зображень, аналізу тональності тексту й обробки мовлення.
Якість анотування даних у машинному навчанні безпосередньо впливає на точність моделі, її послідовність і здатність до узагальнення в реальних сценаріях. Неправильні, суперечливі або заангажовані мітки можуть навчити алгоритми викривленим закономірностям, що призведе до ненадійних результатів і додаткових витрат на повторне навчання. Структурований процес маркування даних допомагає зменшити ці ризики шляхом розробки чітких інструкцій для анотування, застосування єдиних критеріїв розмітки й перевірки готових наборів даних на точність. На практиці маркування даних також дає змогу командам оцінювати роботу моделі на основі відомих еталонних відповідей і виявляти області, які потребують покращення.
Які основні типи анотування даних існують
Основні типи анотування даних відрізняються залежно від формату інформації та завдань, які має виконувати модель ШІ — від розуміння людської мови до розпізнавання об’єктів і інтерпретації аудіо чи відео.
| Тип даних | Приклади анотування | Основне застосування |
| Текст | Оцінка тональності, іменовані сутності, теги намірів (intent tags), класифікація тексту | NLP, чат-боти, аналіз тональності, механізми пошуку |
| Зображення | Обмежувальні рамки (bounding boxes), класифікація зображень, сегментація, ключові точки | Комп’ютерний зір, виявлення об’єктів, розпізнавання облич |
| Аудіо | Транскрипція, ідентифікація мовця, теги звукових подій | Розпізнавання мовлення, голосові помічники, аналіз аудіо |
| Відео | Відстеження об’єктів, позначення дій, покадрове анотування | Автономне водіння, відеоспостереження, розпізнавання активності |
| 3D | 3D-обмежувальні рамки, сегментація хмари точок, відстеження об’єктів | Робототехніка, безпілотні транспортні засоби, аналіз 3D-сцен |
| Геопросторові дані | Географічні координати, маркування карт, контури доріг і будівель, класифікація землекористування | ГІС, аналіз супутникових знімків, навігаційні системи, міське планування |
Анотування тексту
Анотування тексту передбачає розмітку письмових даних, яка допомагає моделям машинного навчання розуміти мову, значення та контекст. Типові завдання охоплюють аналіз тональності, розпізнавання іменованих сутностей (NER), класифікацію тексту й визначення намірів користувача, що є основою для роботи чат-ботів, пошукових систем і застосунків обробки природної мови (NLP).
Анотування зображень
Анотування зображень додає мітки й візуальні маркери на ілюстрації, щоб моделі ШІ могли ідентифікувати об’єкти, людей та інші елементи. Методи охоплюють використання обмежувальних рамок (bounding boxes), багатокутників (polygons) і сегментацію зображень, що широко застосовуються в медичній візуалізації, розпізнаванні облич і системах автономного водіння.
Анотування аудіо й мовлення
Анотування аудіоданих передбачає транскрибування мовлення, ідентифікацію дикторів, маркування окремих звуків і додавання часових міток (таймкодів) до записів. Це допомагає системам ШІ розпізнавати усне мовлення, інтерпретувати голосові команди, аналізувати розмови й відрізняти мову від фонового шуму.
Анотування відео
Анотування відео позначає об’єкти, дії та події у послідовних кадрах, часто відстежуючи їхній рух із часом. Воно є незамінним для систем відеоспостереження, моніторингу дорожнього руху, розпізнавання активності та безпілотного транспорту.
Анотування 3D-хмар точок
Цей тип анотування працює з тривимірними даними, зібраними датчиками, як-от LiDAR. Анотатори ідентифікують і класифікують об’єкти у 3D-просторі, допомагаючи автономним автомобілям і робототехніці орієнтуватися у навколишньому середовищі й оцінювати точне розташування об’єктів.
Анотування геопросторових даних
Геопросторове анотування додає мітки до даних, прив’язаних до локації, зокрема супутникових знімків, карт і географічних координат. Воно підтримує такі області, як міське планування, сільськогосподарський моніторинг, екологічний аналіз і навігація.
Анотування даних чи маркування даних: у чому різниця
Анотування даних (data annotation) і маркування даних (data labeling) є схожими термінами в області штучного інтелекту, і їх часто використовують як синоніми. Однак основна відмінність полягає в масштабі та складності роботи. Маркування даних зазвичай передбачає присвоєння раніше визначених категорій або тегів первинним даним, наприклад, позначення листа як «спам» чи визначення зображення як «автомобіль». Анотування даних для ШІ охоплює ширший спектр завдань, зокрема малювання обмежувальних рамок навколо об’єктів, виділення конкретних слів у тексті, додавання таймкодів до аудіозаписів або визначення складних зв’язків між сутностями. Обидва підходи перетворюють сиру інформацію на структуровані набори даних, які алгоритми можуть використовувати для навчання та прогнозів.
На практиці маркування даних часто вважається складовою частиною (підмножиною) ширшого поняття анотування даних, хоча конкретна термінологія може різнитися залежно від проєкту чи постачальника послуг. Для простих завдань класифікації присвоєння звичайної мітки може бути достатнім для створення якісних навчальних даних. Складніші рішення ШІ, як-от безпілотні автомобілі, обробка природної мови й аналіз відео, вимагають детального анотування, яке фіксує точне розташування об’єкта, його контекст чи взаємозв’язки з іншими елементами. Розуміння цієї різниці допомагає бізнесу чітко визначати вимоги до проєктів, обирати відповідні інструменти й встановлювати стандарти якості.
Як працює процес анотування даних для ШІ
Процес анотування даних починається з визначення цілей моделі машинного навчання та ідентифікації типу даних, необхідних для її навчання. Команди збирають відповідні первинні дані (текст, зображення, аудіозаписи, відео), після чого очищують і впорядковують їх, видаляючи дублікати, невідповідні записи й пошкоджені файли. Далі розробляються чіткі інструкції з анотування, які детально описують, які саме мітки слід застосовувати та як обробляти неоднозначні випадки. На етапі розмітки анотатори-люди, інструменти на основі ШІ або їхня комбінація додають змістовні теги, категорії, транскрипти чи маркери об’єктів до набору даних.
Структурований робочий процес анотування обов'язково містить контроль якості, щоб переконатися, що мітки є точними, послідовними й відповідають вимогам проєкту. Рецензенти можуть перевіряти вибіркові зразки, порівнювати розмітку кількох виконавців і виправляти помилки перед затвердженням набору даних. Після валідації розмічені дані розподіляються на навчальні (training), валідаційні (validation) і тестові (test) вибірки. Далі модель навчається на розмічених прикладах, а оцінка її роботи може виявити прогалини, які вимагатимуть додаткової розмітки або уточнення інструкцій. Цей ітеративний процес допомагає підвищити якість навчальних даних, зменшити кількість помилок і забезпечити надійніші результати машинного навчання.
Які основні методи анотування даних використовуються
Основні методи анотування залежать від типу даних, цілей моделі ШІ та закономірностей, які вона має засвоїти. Анотування тексту для ШІ містить класифікацію документів, виділення ключових слів і маркування сутностей, як-от людей, організації та локації. Анотування зображень використовує такі методи, як обмежувальні рамки (bounding boxes), багатокутники (polygons) і маски сегментації для ідентифікації об’єктів і їхніх меж. Анотування відео розширює ці техніки на послідовні кадри, дозволяючи алгоритмам відстежувати рухомі об’єкти й розпізнавати дії. Аудіоанотування охоплює транскрипцію мовлення, ідентифікацію дикторів і класифікацію звуків.
NLP-анотування даних зосереджується на підготовці текстових і мовних даних для моделей обробки природної мови. Поширені методи охоплюють розпізнавання іменованих сутностей (NER), аналіз тональності (класифікація думок на позитивні, негативні чи нейтральні) і класифікацію намірів (визначення мети повідомлення користувача). Розмітка частин мови (part-of-speech tagging) визначає граматичні ролі слів, а вилучення зв’язків (relationship extraction) виявляє контакти між сутностями в тексті. Для генеративного ШІ анотування також може містити ранжування відповідей моделі, оцінку відповідності та виявлення неточного чи шкідливого контенту.
Як забезпечити якість анотування даних
Забезпечення високої якості анотування даних починається зі створення чітких інструкцій, які визначають категорії, надають наочні приклади й пояснюють, як діяти в сумнівних випадках. Послідовні вказівки допомагають анотаторам застосовувати однакові критерії до різних наборів даних, зменшуючи розбіжності, які можуть негативно вплинути на роботу моделі. Не менш важливими є відбір кваліфікованих виконавців і проведення спеціалізованого навчання, особливо для вузькопрофільних галузей, що вимагають експертних знань. Також варто використовувати спеціалізовані інструменти анотування для стандартизації робочого процесу, позначення сумнівних прикладів і мінімізації ручних помилок. Запуск пілотних проєктів перед початком масштабної розмітки допомагає завчасно виявити нечіткі формулювання в інструкціях.
Надійний процес забезпечення якості поєднує автоматизовані перевірки з людським рецензуванням. Команди можуть вимірювати рівень згоди між анотаторами (inter-annotator agreement), аудіювати випадкові вибірки й залучати експертів для вирішення складних випадків. Автоматизовані правила валідації виявляють пропущені мітки, некоректні формати й дублікати, тоді як регулярний зворотний зв’язок допомагає анотаторам виправляти повторювані помилки. Постійна оцінка й вдосконалення стандартів анотування дають змогу зменшити кількість переробок, контролювати витрати на розмітку й надавати моделям машинного навчання надійні дані для навчання та оцінювання.
Які виклики можуть виникати у проєктах з анотування даних
Проєкти з анотування даних можуть стикатися з низкою викликів, які впливають на якість наборів даних, терміни реалізації та кінцеву точність моделей ШІ. Однією з найпоширеніших проблем є непослідовність розмітки, адже різні анотатори можуть по-різному трактувати інструкції, особливо під час роботи зі складними чи неоднозначними даними. Масштабні проєкти також можуть бути дорогими й тривалими, вимагаючи залучення кваліфікованих фахівців, спеціалізованих інструментів і постійного контролю якості.
Спеціалізовані послуги розмітки даних для ШІ допомагають організаціям долати ці труднощі, надаючи навчених анотаторів, відпрацьовані процеси контролю якості та масштабовані рішення для конкретних вимог. Наприклад, анотування в області обробки природної мови може бути особливо складним, коли текст містить сарказм, культурні алюзії, двозначні вирази чи мовні нюанси, які автоматизованим інструментам важко інтерпретувати належним чином. Інші перешкоди охоплюють заангажовані або нерепрезентативні набори даних, обмежену доступність галузевих експертів, питання конфіденційності даних і складність підтримки єдиних стандартів для кількох мов і типів даних.
Автоматизовані інструменти анотування прискорюють процес, але можуть припускатися помилок, що вимагають обов’язкової перевірки людиною. Щоб подолати ці виклики, організаціям слід формувати чіткі інструкції, проводити навчання анотаторів, впроваджувати багаторівневий контроль якості та регулярно проводити аудит розмічених наборів даних. Поєднання людської експертизи з автоматизацією дає змогу підвищити послідовність розмітки, оптимізувати витрати й отримувати надійні навчальні дані для моделей машинного навчання.
Рекомендований контент
Переклад чи транскрипція: у чому різниця?
Що таке транслітерація? Відмінності від перекладу та транскрипції
Що таке лінгва франка? Значення, приклади та основні області використання